過去兩年,行業談AI 編程時,注意力長期停在模型本身:參數規模、上下文長度、榜單得分。但模型能力只是起點,任務完成率才是終點。一個模型能生成看似合理的代碼,不代表它能穩定走完需求理解、倉庫探索、代碼修改、測試執行、錯誤恢復與結果驗收——任一環節失效,局部正確的代碼就會變成整體失敗的任務。基于這一判斷,我們研發的“伯樂大模型”,不是堆參數的單體模型,而是優勢互補的專家模型組合(總參數 ≤100B),它與組件化 Agent 框架、Skill 工程方法庫共同構成“任務執行引擎”,讓模型能力從“會寫”走向“能完成”。在這套引擎里,模型能力只占三分之一——另外三分之一來自 Agent 對行動的組織,三分之一來自 Skill 方法的注入。
一、伯樂大模型:能力互補,而非堆參數
任務執行引擎的模型層——伯樂大模型——是系統級專家模型組合,核心是建立一張“模型能力地圖”:哪個模型更擅長需求拆解與規劃,哪個更擅長跨文件代碼生成,哪個對工具調用格式更穩定,哪個更適合發現補丁缺陷。系統據此做兩種調度。任務級選擇:任務開始前,按語言、倉庫類型、復雜度、變更范圍等特征,選更適合擔任主執行者的專家模型。階段級切換:同一任務內,由推理模型負責拆解方案,代碼模型完成修改,審查模型檢查補丁與測試結果。我們不再追求“讓一個模型在每個維度都成為第一”,而是追求讓每一個模型在它最擅長的位置發揮作用,并通過系統協同補齊彼此短板。
二、組件化Agent:把能力組織成可驗證的行動
模型決定“能做什么”,Agent 解決“按什么流程做、如何使用環境、怎樣判斷完成”,系統則按任務特征決定“由誰來做”。我們的 Agent 框架采用組件化設計,把核心能力拆成可插拔、可替換、可觀測的組件:
- 任務規劃器:將目標拆成可執行子任務,維護依賴與進度;
- 上下文管理器:控制哪些信息進入模型,避免窗口被無關內容占據;
- 模型適配器:統一上層調用接口,同時保留針對各專家模型的適配策略;
- ACI 工具層:把文件讀取、代碼檢索、結構化編輯、Shell、測試、靜態分析、LSP 等通過統一協議向 Agent 暴露;
- 執行循環:根據計劃驅動模型行動,將工具結果寫回共享狀態;
- 驗證與終止:根據測試、靜態檢查、補丁差異和驗收條件判斷是完成、重試還是切換模型或Skill。
- 組件化價值:某專家模型變化或某類任務暴露新短板時,可替換適配器、上下文策略、驗證器或執行循環,而不必推翻整個系統。
三、Skill Hub:不是 Prompt 倉庫,是工程方法庫
Agent 框架定義“系統如何行動”,Skill 定義“這類問題該用什么方法行動”。Skill Hub 沉淀可復用的軟件工程能力——需求澄清與任務拆解、倉庫結構分析與代碼檢索、Bug 復現與根因定位、跨文件修改與影響面檢查、測試驗證、代碼審查與風險識別、構建部署與運行環境排障等。但Skill 不是一段更長的 Prompt。一個可用的 Skill 至少包含:觸發條件、適用邊界、輸入輸出契約、操作步驟、工具約束、驗收標準、失敗回退。這使 Skill 從“提示詞片段”變成可執行、可評估、可迭代的工程資產。同時,系統讀取任務特征與模型畫像,通過輕量級路由召回當前階段所需的最小Skill 集合,避免把整個 Hub 塞進上下文造成膨脹與沖突。最優Skill 集合 = 任務匹配度 + 模型適配度 + 歷史有效性 ? 規則沖突 ? 上下文成本這套機制的重點不是使用復雜路由模型,而是在較低成本下,讓Skill 選擇具有可解釋性、穩定性和可持續迭代能力。
四、三者協同:系統有效性是乘法,不是加法
模型提供能力,Agent 組織行動,Skill 注入方法——這是三個執行層;驗證閉環則貫穿三者、約束全程。三者不是簡單相加,而是相互約束、相互增強。系統有效性更接近一個乘法關系:系統有效性= 模型能力 × Agent 執行質量 × Skill 匹配質量 × 驗證閉環任一層偏弱都會拉低最終任務完成率;優化目標是在資源預算(時延、上下文、調用次數、算力)內提升整體乘積,而非無條件堆投入。以跨文件Bug 修復為例,系統會依次完成“建立任務畫像—選擇主模型與 Skill—Agent 組織探索—按階段切換能力—驗證失敗后重新路由—形成可學習反饋”的閉環,讓優化從“調 Prompt”轉向“基于任務軌跡定位問題”。
五、便攜式智力工廠:把任務執行引擎帶到現場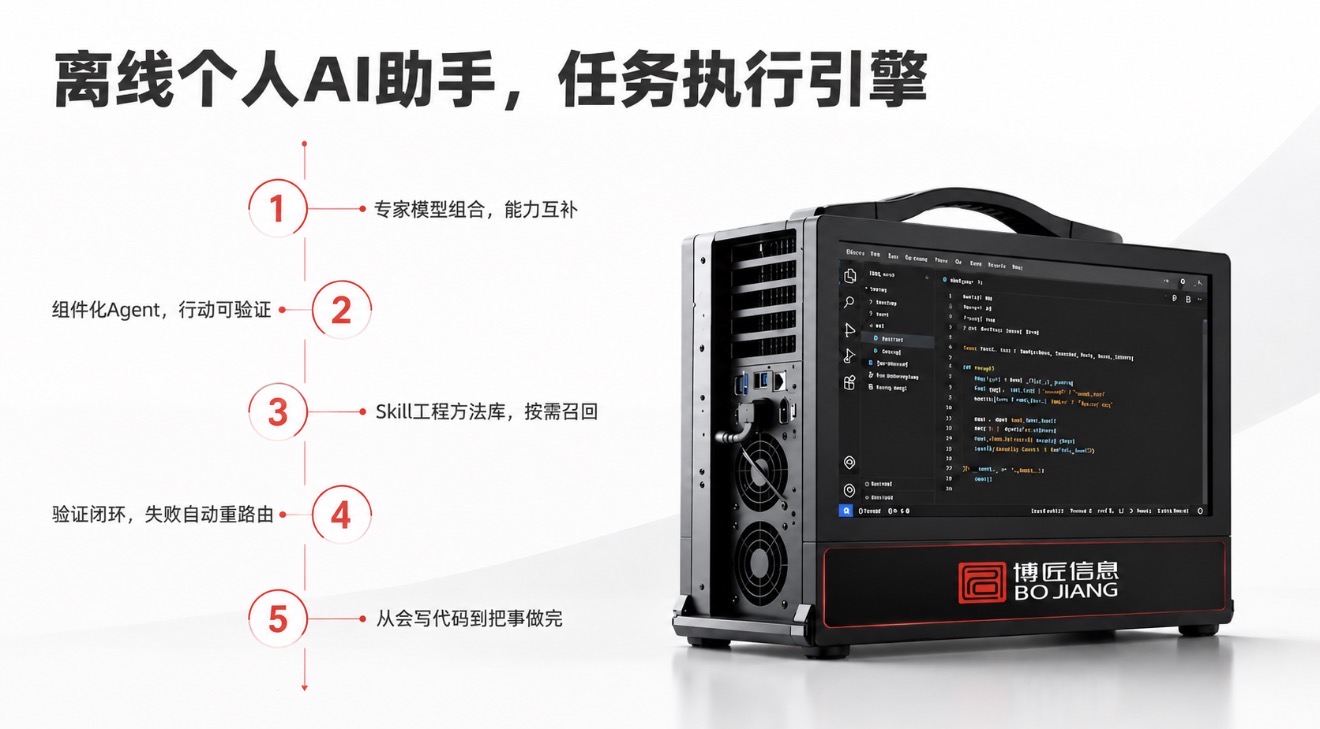
技術架構回答了“系統如何把任務做完”,但還有最后一個問題:這套系統應當出現在哪里?若只存在云端,它只能處理“已上傳的數據”,碰不到現場設備與代碼,也繞不開出網、合規與延遲。若只是一臺裝本地 LLM 的筆記本,缺的就不是模型,而是把能力組織成可驗證行動的 Agent 與 Skill 底座——結果是會聊天的模型,而非能把事做完的系統。離線個人AI 助手(便攜式智力工廠)給出的答案是:把整套任務執行引擎,以離線、私有、便攜的形態,帶到工作真正發生的地方。
- 離線私有化部署:模型權重與推理全在本機,代碼與數據不出設備,把“任務執行引擎”關進一個物理不出門的盒子;
- 便攜隨身:單臺工作站,辦公室、家中、客戶現場通用,系統隨人走;
- 邊緣算力:本地大模型實時推理,零網絡RTT,交互實時;
- 一體閉環:開箱即用,免IT 集成、免立項,工程師拎著就能用;
- 全過程留痕與報告自動匯總:把每一次任務軌跡沉淀為可復用的組織資產。
這正是廉價“本地 LLM + 手工流程”難以復制的:后者能跑模型,卻缺把能力組織成可驗證行動的工程底座;而云端方案能跑同樣的架構,卻到不了現場、碰不到設備,數據出網還繞不開合規審查與傳輸延遲。
結語:模型決定可能性,系統決定完成度
大模型仍是能力基礎,但參數規模不是唯一變量。模型決定可能性,Agent 決定行動組織,Skill 決定方法注入——三個執行層各占三分之一、缺一不可;當它們與驗證閉環結合,一個總參數 ≤100B 的組合也能形成遠超單次調用的系統能力。而當任務執行引擎以離線、私有的形態裝進便攜式智力工廠,模型負責“能不能”,系統負責“做沒做成”——AI 從“會寫”落到“做完”。